前端怎么用 WebAssembly?从一个浏览器图片压缩工具说起
前端怎么用 WebAssembly?从一个浏览器图片压缩工具说起
做一个图片上传功能,最开始通常很简单:选文件,预览,调接口。需求慢慢加上来,事情就变了。图片太大,要先压一压;格式不统一,希望转成 WebP;用户还想拖动质量滑杆,看清楚压完的效果再上传。
这些工作当然可以交给服务端。但如果图片就在用户电脑里,处理完只需要一个文件,也可以把这一段留在浏览器里完成。页面负责交互,浏览器负责读图,编码库负责生成新的图片。
WebAssembly 就可以出现在这里。对前端开发者来说,日常接触它的入口往往是一个 npm 包:安装、导入、异步调用,然后把返回的数据接回页面。我们关心的是这段能力怎么进入现有项目,以及用户点下按钮后,页面能不能一直好好响应。
这篇文章用 JavaScript + Vite + Web Worker 做一个本地图片转 WebP 的小工具。Wasm 编码器使用现成的 @jsquash/webp,整个案例只写前端代码。
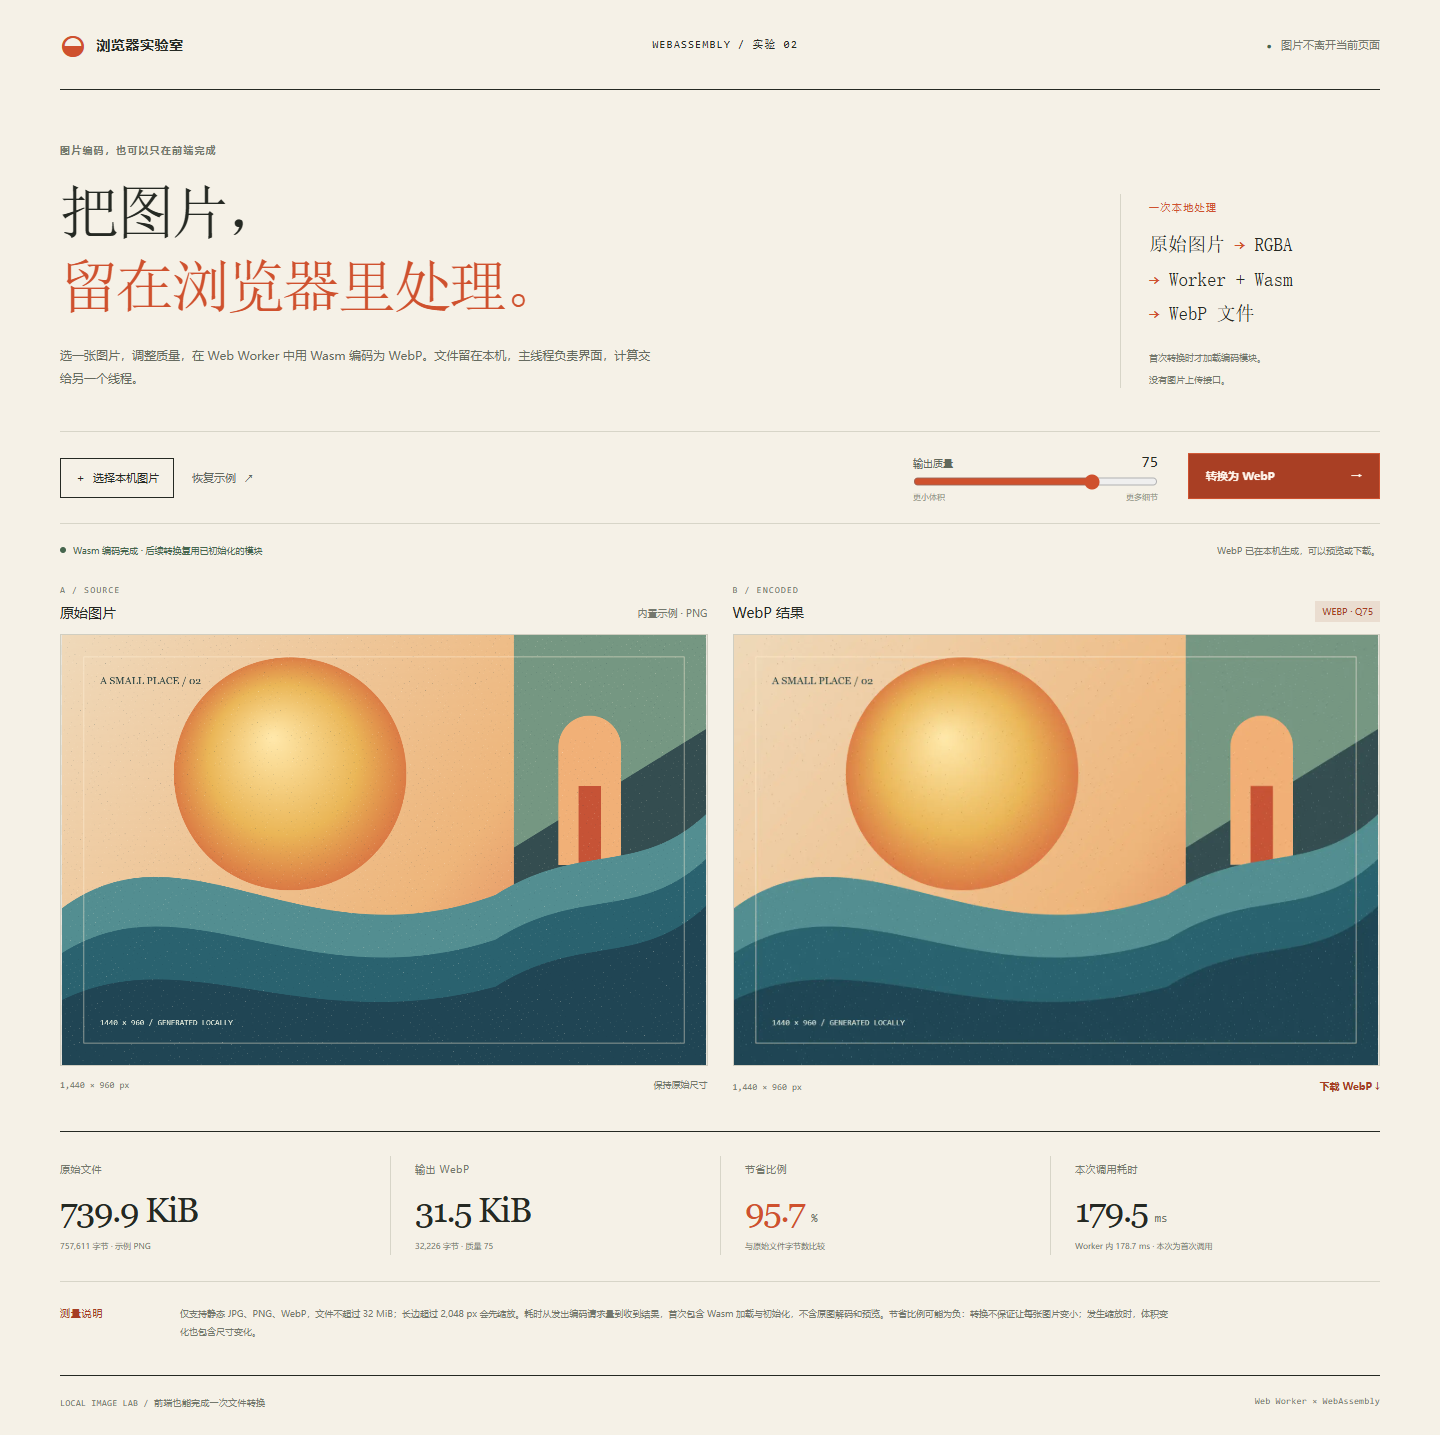
截图使用的是内置生成的 PNG 示例,显示的体积和耗时只对应这一次处理。
先把 Wasm 放回前端项目里
可以把 WebAssembly 理解为一种浏览器能够加载和执行的二进制模块格式。编解码、压缩、解析等底层能力可以编译成 .wasm,再通过 JavaScript 接进应用。页面渲染、按钮事件、网络请求、业务状态,仍然按熟悉的方式编写。MDN:WebAssembly 的基本概念
落到本例,分工是这样的:
1 | 用户选择本地图片 |
这里有两个不同的东西:Wasm 提供编码能力,Worker 提供一个独立的执行线程。 加载 Wasm 本身不会自动把计算移出主线程,给函数加上 async 也不能保证计算期间页面流畅。编码工作放进 Worker 后,主线程才能继续处理点击、滚动和状态更新。MDN:使用 Web Workers
这个分工也很适合已有的 React、Vue 项目。组件管理交互和生命周期,编码服务封装 Worker,底层库留在 Worker 内部。组件里不需要出现指针、编译参数或者内存分配函数。
做图片压缩,先看看浏览器已经有什么
在安装依赖之前,值得先停一下。Canvas 本来就有 toBlob(),不少浏览器支持直接导出 WebP:
1 | const blob = await new Promise((resolve) => { |
这个办法对于普通的上传前缩放、压缩,可能已经够用。要检查 blob.type,是因为浏览器不支持请求的编码格式时,可能退回 PNG;不能只把文件后缀改成 .webp 就当作转换成功。这里的原生 quality 范围是 0 到 1。MDN:Canvas toBlob
引入 Wasm 编码库的价值,在于使用随项目分发的编码实现,以及库开放的参数和能力。它也会带来额外的模块下载与初始化成本。选择哪种方式,还是要回到需求:
| 实际需求 | 可以先考虑的方案 |
|---|---|
| 上传前简单缩放,转成浏览器支持的图片格式 | Canvas 原生 API |
| 需要某个编码库的实现和更细的编码选项 | 相应的 Wasm 编码库 |
| 需要统一的服务端图片管线,或者终端处理能力不足 | 服务端处理 |
本例选用 jSquash,是为了走通“前端接入现成 Wasm 库”这条链路。它提供面向浏览器与 Worker 的图片编解码包,WebP 包基于 libwebp。我们只引入需要的编码入口。jSquash 项目
案例要做成什么样
页面接收静态 JPG、PNG、WebP,展示处理前后的图片,允许调整编码质量,并下载转换结果。图片不会上传到业务服务器;浏览器仍会请求页面、脚本和 Wasm 等静态资源。
为了让示例在普通电脑上更容易运行,单个输入文件限制为 32 MiB,编码前将图片最长边缩到 2048 像素。页面会显示实际输出尺寸。大图的体积下降可能同时来自缩小尺寸、改变格式和有损编码,不能全算在 Wasm 头上。
案例固定使用 @jsquash/webp 1.5.0 和 Vite 8.3.5,附带锁文件。解压后有两种启动方式:
1 | # 直接体验:包内已经带有 dist,只需要 Node.js |
npm start 默认服务地址是 http://127.0.0.1:4180,在浏览器中访问即可。不要直接双击 HTML;模块脚本、Worker 和 Wasm 资源需要通过 HTTP 服务加载。
源码的主要文件只有这些:
1 | src/app.js 选择文件、Canvas、预览与页面状态 |
第一步:把文件变成编码器能接收的像素
用户选到的是 File,编码器需要的是像素数据。这一步可以用浏览器熟悉的 API 完成:先解码图片,画到 Canvas,再取得 ImageData。
下面的函数摘出了这条路径。文件类型和大小检查放在调用前,界面中还会处理读取失败。
1 | async function readPixels(file, maxEdge = 2048) { |
ImageData.data 是一个 Uint8ClampedArray,这里每个像素按 RGBA 使用四个字节。它和原始 PNG、JPEG 文件的压缩字节是两回事。编码器拿到的,是已经解码的像素。MDN:ImageData
这也解释了一个容易忽略的问题:文件只有几兆,展开后的像素可能已经很大。一张 4000 × 3000 的图,仅一份 RGBA 缓冲区就约 45.8 MiB。再算上解码图像、Canvas 和编码器的内存,实际占用还会增加。案例的缩放会减少后续像素与编码开销,但原图解码仍然有成本,文件大小限制不能等同于内存上限。
第二步:在 Worker 里调用 Wasm
@jsquash/webp 已经包装了 Wasm 的初始化和调用。使用编码入口时,业务代码拿到的是一个异步函数:
1 | import encode from '@jsquash/webp/encode.js'; |
注意参数单位:这个库的 quality 使用 0 到 100,与前面 Canvas API 的 0 到 1 不同。结果是 WebP 文件的 ArrayBuffer。WebP 包的使用说明
编码库会在首次使用时加载编码器,并复用模块初始化的 Promise;当前实现还会根据 SIMD 支持选择对应版本。应用没有必要每点击一次就重新实例化整个 Wasm 模块。编码入口实现
在案例中,我们把它放到 encode.worker.js。文件还保留了像素视图的偏移量,并向页面返回错误,流程如下:
1 | import encode from '@jsquash/webp/encode.js'; |
主线程使用下面的形式创建 Worker,Vite 能识别并生成它需要的构建资源。new URL() 直接写在 new Worker() 内部,路径保持静态字符串。Vite:Web Workers
1 | const worker = new Worker( |
案例里的 encoder.js 再把请求 ID、消息监听和错误传播封装起来,让页面可以使用 await encoder.encode(imageData, quality)。这层封装很普通,但对组件代码很有用:页面只需要知道什么时候成功、什么时候失败,以及何时释放服务。
第三步:传数据时,留意缓冲区的归属
把一大块像素交给 Worker 时,可以在 postMessage() 的第二个参数中转移它的 ArrayBuffer:
1 | worker.postMessage( |
转移完成后,发送方原来的缓冲区会被分离,不能继续拿它当作完整像素来读。这是所有权变化,不能把它当成“复制了一份过去”。案例保留 Canvas 作为预览来源,每次编码重新取得一份 ImageData,因此调整质量后还能再次转换。MDN:可转移对象
还需要区分两条边界:这里处理的是主线程和 Worker 之间的数据传递;编码库内部如何把像素交给 Wasm,则由它自己的封装负责。使用 transfer 列表,不能据此宣称整条链路完全没有数据复制。
第四步:把结果接回页面
Worker 返回的是文件字节,接下来就是前端日常写法:构造 Blob,生成临时 URL,交给图片和下载链接。
1 | import { createEncoder } from './encoder.js'; |
这里的 preview 和 download 分别对应页面的图片元素与下载链接,readPixels() 是前面的函数。完整案例还处理了按钮状态和异步请求的先后顺序。
临时 URL 需要在结果被替换、页面销毁等不再使用它的时候回收。不要在刚设置 img.src 后就立即撤销,否则后续预览或保存操作可能受到影响。MDN:回收对象 URL
接入组件时,主要要管好三个时间点:开始处理时设置 loading;结束时恢复按钮并显示结果或错误;组件卸载时终止 Worker、回收 URL。React 可以把清理放在 effect 的返回函数里,Vue 可以放在 onUnmounted() 中。重复选择文件时,再用一个递增的任务编号挡住旧结果,避免上一张图片处理完成后覆盖新预览。
这些代码通常比 await encode() 本身更容易影响使用体验。Wasm 成功返回字节,只完成了功能的一部分。
本地正常,打包之后也要再跑一次
Wasm 库一般由 JavaScript 包装代码和二进制资源组成。开发服务器能找到文件,不代表部署到子目录以后还一定找得到。
案例采用下面的 Vite 配置:
1 | import { defineConfig } from 'vite'; |
optimizeDeps.exclude 沿用 jSquash 给 Vite 的处理建议,避免依赖预打包干扰模块内部的 Wasm 路径。Worker 使用 ES 格式,是本例配合编码入口动态模块加载的配置选择。jSquash 的 Vite 示例、Vite Worker 输出配置
部署时,可以重点看这几件事:
| 要看的位置 | 想确认的问题 |
|---|---|
| 构建目录 | Worker、编码器脚本和 .wasm 是否一起输出、一起发布 |
| Network 面板 | Wasm 请求是否 200,返回的是否二进制,而非被路由回退成 HTML |
| 响应头 | .wasm 是否使用 application/wasm;跨域资源是否有相应 CORS 配置 |
| 真实部署路径 | 网站放在子目录时,资源地址有没有跑到错误的根目录 |
| 冷启动 | 首次加载与失败提示能否正确走通 |
application/wasm 与浏览器的流式编译接口有关;不能只检查文件名后缀。MDN:instantiateStreaming
本例使用普通 Worker 和单线程编码器,没有共享 Wasm 内存的需求。以后选用依赖共享内存的多线程库时,再根据那个库的要求配置跨源隔离。Worker 和 Wasm 多线程并不是同一个概念。
别急着写“性能提升了多少倍”
这个案例可以证明前端调用链跑通,也能观察输出体积和等待时间。它没有设置同等条件下的另一套编码实现,因此不提供“Wasm 比 JavaScript 快多少”的结论。
即便只测这个工具,计时也要说清楚范围。页面显示的往返耗时,从调用编码服务开始,到收到 Worker 的结果结束,包含通信,以及首次发生的编码器下载和初始化;它不包含之前的文件解码与缩放,也不是整个选图流程的总耗时。Worker 内部的编码耗时则围绕 await encode(),首次也包含该调用触发的初始化。
后续再处理图片时,已经加载的模块可以复用。把第二次的热运行时间与另一条路径的首次加载时间放在一起比较,很容易得到漂亮却没有意义的数字。
同样,转换后也未必总是更小。原图已经压缩得很好、图片很小,或者质量设得很高,都可能让输出增加。页面应该照实显示结果,允许出现负的节省比例。决定是否保留转换文件时,文件体积和视觉效果要一起看。
对用户体验来说,还可以观察编码期间能否滚动页面、其他交互是否仍有响应。本例会暂时禁用质量滑杆,避免处理中切换参数让输出含义变得不清楚。Worker 的直接收益是让主线程有机会继续响应,并不保证总耗时一定下降。本例的解码、缩放和 Canvas 取像素仍在主线程,特别大的图依然需要继续分析这部分开销。
跑通一个小工具之后,再回到自己的项目
完整案例包含内置演示图、本地文件选择、质量调整、双图预览和下载。它也明确限定了静态图片:动画 PNG、动画 WebP 会提示不支持,避免用户以为转换结果保留了整段动画。
案例已经在 Chrome 中实际运行过正式构建:静态 JPG、PNG、WebP 输入可以生成可解码的 WebP;透明像素的 alpha 得到保留;3000 × 1500 的输入按规则输出为 2048 × 1024;修改质量后能够再次编码,下载内容与预览使用的文件字节一致。也验证了 Wasm 加载失败后的提示与重试,以及手机宽度下的布局。这里验证的是案例功能,浏览器兼容范围仍需按自己项目的目标设备继续确认。
如果要把它接入上传组件,可以把最后一步的 WebP Blob 包装成 File,再交给现有上传流程:
1 | const uploadFile = new File([webpBlob], 'image.webp', { |
这时候,WebAssembly 已经变成了前端功能中的一段实现。用户看到的是选图后能预览、能调整、能下载;开发者维护的是清楚的数据流、可处理的错误,以及可复现的构建过程。
从这样的入口开始,Wasm 就容易理解多了。先找一个边界明确的需求,把现成的能力接进来,看看它给页面带来了什么,也看看它增加了哪些成本。等到确实需要维护底层算法时,再往编译工具链那一层走。
本文案例与阅读资料:
前端怎么用 WebAssembly?从一个浏览器图片压缩工具说起
https://hjb.leheavengame.com/2026/11/08/前端怎么用-WebAssembly?从一个浏览器图片压缩工具说起/